Captioner – Bildbeschriftung für KI-Training
Typ: Software Status: MVP Tech Stack: Python, FastAPI, Uvicorn, Pydantic, Pillow, React 18, Vite, Tailwind CSS, HuggingFace Transformers, PyTorch, Florence-2, JoyCaption, Docker, CUDA Problemstellung Das Training von KI-Bildmodellen, etwa LoRA- oder Diffusion-Feintuning, erfordert Bilddatensätze, in denen jedes Bild eine passende Textbeschreibung als gleichnamige .txt-Datei neben sich hat. Diese Beschreibungen von Hand im Texteditor zu pflegen

DIE IDEE
Captioner – Bildbeschriftung für KI-Training
Typ: Software Status: MVP Tech Stack: Python, FastAPI, Uvicorn, Pydantic, Pillow, React 18, Vite, Tailwind CSS, HuggingFace Transformers, PyTorch, Florence-2, JoyCaption, Docker, CUDA Problemstellung Das Training von KI-Bildmodellen, etwa LoRA- oder Diffusion-Feintuning, erfordert Bilddatensätze, in denen jedes Bild eine passende Textbeschreibung als gleichnamige .txt-Datei neben sich hat. Diese Beschreibungen von Hand im Texteditor zu pflegen ist mühsam und fehleranfällig. Einzelpersonen und kleine Teams brauchen dafür eine bequeme Oberfläche, die Bild und Beschreibung nebeneinander zeigt und leere Captions von einem lokalen Vision-Modell vorbefüllen lässt, ohne dass die Trainingsbilder die eigene Maschine verlassen. Beschreibung Captioner ist eine schlanke, lokal betriebene Web-Anwendung (React-SPA + FastAPI-Backend), die einen Bilder-Ordner rekursiv einliest und für jedes Bild ein editierbares Caption-Feld bereitstellt. Die Beschreibungen werden als gleichnamige .txt-Sidecar-Dateien neben den Bildern gespeichert — das Format, das gängige LoRA- und Diffusion-Trainings erwarten. Leere Captions lassen sich automatisch füllen: über lokale Vision-Modelle (Microsoft Florence-2, JoyCaption via HuggingFace) oder einen Dateinamen-Fallback, gekapselt in einer Provider-Registry mit Laufzeit-Verfügbarkeitsprüfung. Ausgaben entstehen als Fließtext oder als normalisierte, kommagetrennte Tag-Liste. Betrieben wird das Tool über drei Docker-Compose-Varianten (UI-only, CPU-Vision, GPU-Vision mit CUDA), sodass Trainingsbilder die eigene Maschine nicht verlassen; eine Datenbank gibt es nicht, der Speicher ist das Dateisystem. Der Kern-Workflow ist fertig, automatisierte Tests, Upload-UI und Batch-Steuerung fehlen noch. Anwendungsfall Ein einfaches Werkzeug, mit dem man viele Bilder bequem beschriftet und die Texte von einer lokalen KI vorausfüllen lässt, um daraus Trainingsdaten für eigene Bild-KI-Modelle zu machen. Link: https://github.com/rawk7000/captioner (privates Repo)
WEITER EINTAUCHEN
Weitere Projekte
Drei weitere Arbeiten aus dem Archiv. Mit einem Baustein „Kartenliste“ lässt sich die Auswahl je Projekt anpassen.
 PROJEKTE
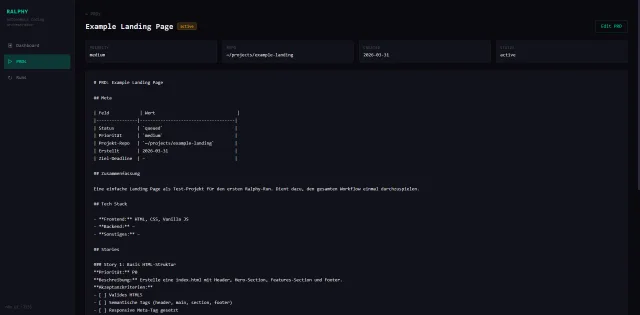
Ralphy – Autonomer KI-Coding-Loop
Typ: Software Status: In Entwicklung Tech Stack: Bash, Claude Code (CLI), Obsidian (Markdown/REST API), n8n (Docker mit PostgreSQL/Redis), Telegram Bot, Git Problemstellu...
↗ PROJEKTE
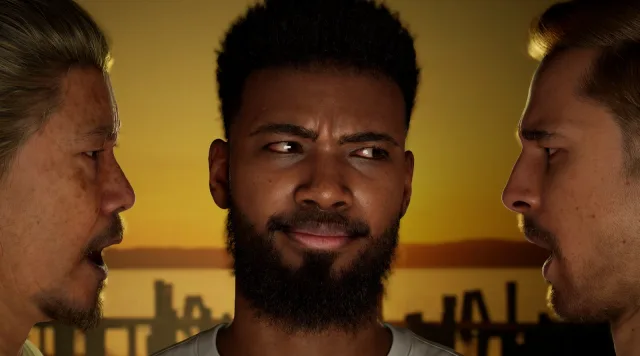
kAI zero – Virtueller Künstler
Typ: Kunstprojekt Status: V.1.0 Tech Stack: Suno, Unreal Engine, Motion Capturing Problemstellung Die Musikindustrie steht vor der Frage, wie KI-generierte Musik authenti...
↗ PROJEKTE
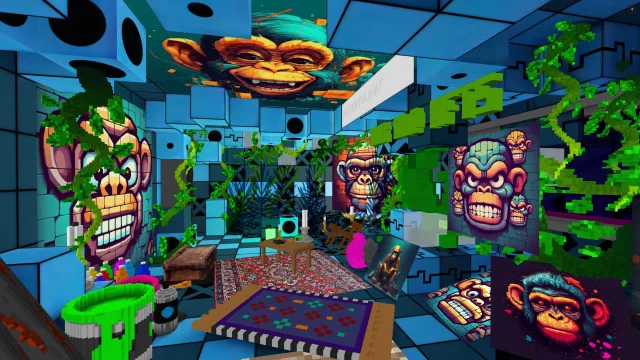
Landesgalerie.com
Landesgalerie.eth ist eine innovative virtuelle Kunstgalerie im Cryptovoxels-Metaverse und bald auch in Otherside, die sich der Förderung digitaler Kunst, der Integration...
↗SEND A SIGNAL
LET’S MAKE
SOMETHING
monstrous.
Eine Idee, die nicht ins sichere Fahrwasser passt?
Für außergewöhnliche Kollaborationen, Consulting und Workshops: schick ein Signal.